AI会取代我们吗——它不懂孤独是什么意思
这是 「AI是怎么回事」 系列的第 16 篇,也是最后一篇。我一直很好奇 AI 到底是怎么工作的,于是花了很长时间去拆这个东西——手机为什么换了发型还能认出你,ChatGPT 回答你的那三秒钟里究竟在算什么,AI 为什么能通过律师考试却会一本正经地撒谎。这个系列就是我的探索笔记,发现了很多有意思的东西,想分享给你。觉得不错的话,欢迎分享+关注。
第一次看到这个系列?从第1篇开始最顺畅,直接读这篇也没问题。
从第 1 篇”你的手机是怎么认出你的脸”到现在,我们一起走过了 16 篇。
拆开了 AI 的黑箱,画出了它的能力边界,学会了怎么和它一起工作。
最后一篇,我想聊一个更大的问题——这个问题你可能从第 1 篇就开始想了:
AI 会取代我们吗?
要回答这个问题,我们先来做一个实验。
AI 会写”孤独”,但它不懂”孤独”
我让 ChatGPT 写一段关于孤独的文字。它给了我这样一段:
孤独是深夜里空荡的房间,是人群中无人对视的目光,是心里有千言万语却找不到一个可以倾诉的人。它不是独处,而是渴望连接却无法触及的距离。
写得很好。甚至可以说,写得比很多人都好。
但它懂孤独吗?
让我用我们在这个系列里学过的知识来拆解这件事。
还记得第 6 篇讲的吗?ChatGPT 的本质是一个语言模型——它做的事情是”预测下一个最可能的词”。当我输入”写一段关于孤独的文字”,它的注意力机制(第 6 篇)在 1750 亿个参数(第 4 篇)中搜索,找到训练数据中关于”孤独”这个主题的大量文学作品、散文、诗歌、心理学文本中的统计模式,然后用这些模式”续写”出一段文字。
“深夜里空荡的房间”——因为在训练数据中,”孤独”和”深夜””空荡”经常出现在相似的上下文里。
“人群中无人对视的目光”——因为在训练数据中的文学作品里,这样的意象和”孤独”高度共现。
每一个词都是”在关于孤独的文本中,这个位置最可能出现什么词”的结果。
这和第 7 篇里讲的律师假判例是完全一样的机制。 律师案件中,ChatGPT 生成了”看起来像法律引文”的文字;在这里,它生成了”看起来像描写孤独”的文字。
区别只在于:法律引文可以去数据库核查真假,而关于孤独的文字没有”对错”之分——所以我们更容易被打动,更容易觉得”它懂了”。
但它没有懂。
它从未在深夜里独自醒来,盯着天花板,感到一种说不清的空洞。 它没有身体,没有感受,没有经历。它有的只是几千亿个通过训练调整好的数字——这些数字让它能生成统计上最可能的文字序列。
哲学家 John Searle 在 1980 年提出过一个著名的思想实验,叫「中文房间」(Chinese Room):一个完全不懂中文的人被关在房间里,靠一本规则手册回复中文信息。外面的人觉得他完全懂中文——但他只是在按规则操作符号。
ChatGPT 就是一个巨大的中文房间。它的”规则手册”是 1750 亿个通过训练自动学出来的参数。规则更复杂了,但本质没变:操作符号,不理解意义。

这就是标题的含义:AI 可以写出关于孤独的优美文字,但它不懂”孤独”是什么意思。
在回答”取代”之前,先回顾我们学了什么
要回答”AI 会不会取代我们”,我们需要先搞清楚 AI 到底是什么、能做什么、不能做什么。
好消息是——你已经知道了。
让我用一张图把整个系列的知识串起来。
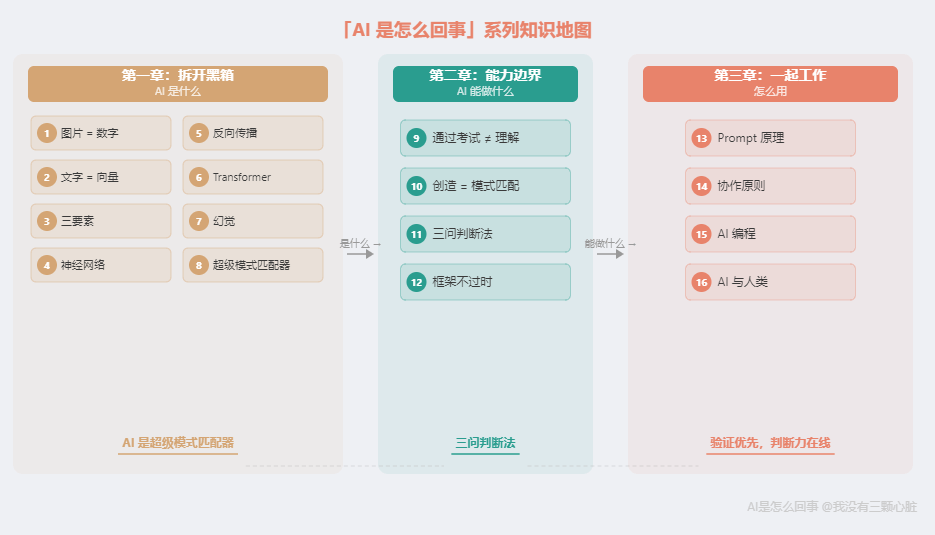
如果你真的从第 1 篇读到了这里,你现在手里有一套完整的装备:
- 一个定义:AI 是超级模式匹配器
- 一套原理:数字化→神经网络→训练→Transformer→统计预测
- 一个框架:AI 认知三角(模式明确+数据充足+可验证= AI 强项)
- 一个工具:三问判断法(模式匹配?数据够?能验证?)
- 一套方法:Prompt 原理+协作原则+验证优先
带着这套装备,我们来正面回答那个大问题。
AI 会取代我们吗?——用原理回答
这个问题其实可以拆成三个更具体的问题。
第一个问题:AI 会取代哪些工作?
还记得第 11 篇的模式匹配谱系吗?
← 纯模式匹配(AI 强区)——— 需要因果理解(AI 弱区)→
世界经济论坛的《2025 年未来就业报告》调查了全球 1000 多家领先企业,预测 2025 年到 2030 年间,全球将新增 1.7 亿个岗位,同时有 9200 万个岗位被淘汰——净增 7800 万个工作岗位。
被淘汰最多的是什么岗位?文员和行政人员——这些工作的核心是处理标准化的信息,正好落在模式匹配谱系的左侧。
增长最快的是什么?STEM 专业人员、医疗健康人员、AI 和大数据专家——这些工作需要理解、判断和创造,落在谱系的右侧。
麦肯锡的研究估计,现有 AI 技术理论上可以自动化约 60% 至 70% 的工作活动,其中超过 40% 的岗位有被完全自动化的潜力。但同时,他们也发现超过 70% 的雇主看重的技能既用在可自动化的工作中,也用在不可自动化的工作中——也就是说,大多数人类能力在 AI 时代仍然有用,只是使用的方式会变。
用我们的框架翻译一下:
凡是能转化为模式匹配的工作环节(整理数据、套用模板、翻译文本、客服应答),AI 会做得更快更便宜。 这些环节会被自动化,就像计算器取代了手工算账一样。
凡是需要理解、判断和创造的工作环节(诊断复杂问题、做伦理决策、建立人际信任、应对前所未见的情况),AI 做不到。 这些环节会变得更有价值。
所以更准确的说法不是”AI 取代工作”,而是**「AI 取代工作中可以模式匹配的部分」**。
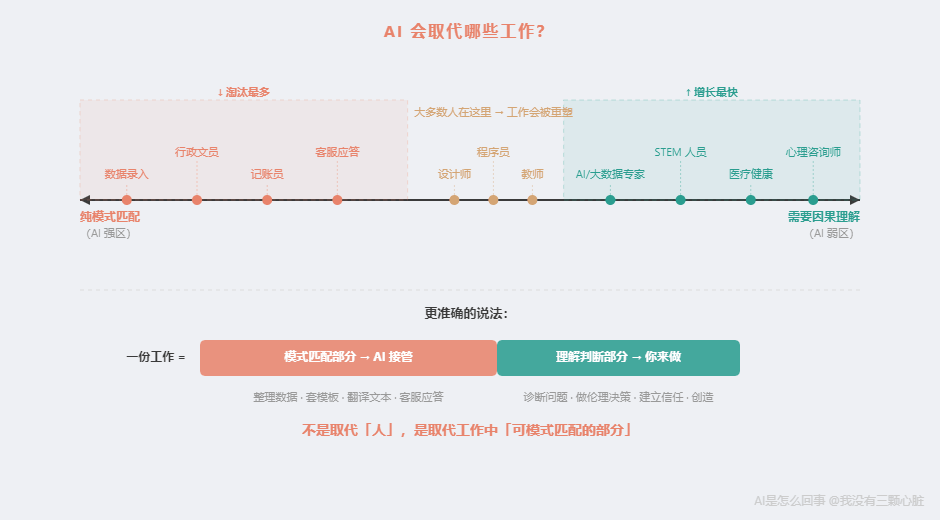
大多数人的工作,不会整个消失——但会被重塑。你的工作中那些重复性的、模式化的部分会被 AI 接管,而你会花更多时间在需要思考和判断的部分。
第二个问题:AI 以后会不会”真的”理解?
这是一个更深层的问题。
我们在第 12 篇里提到过,Yann LeCun(图灵奖得主、Meta 首席 AI 科学家)认为大语言模型是“通往 AGI 的一条岔路”。Gary Marcus(认知科学家)多年来一直警告,统计模式匹配无法实现真正的理解。
他们的理由,用我们学过的知识来解释,就是这样的:
当前 AI 的底层原理是”在训练数据中寻找统计模式”。 这意味着:
- 它只能”匹配”见过的模式,不能”理解”为什么这些模式存在(第 7 篇:统计相关性 ≠ 因果理解)
- 它没有对世界的内部模型——不知道苹果松手会掉下来,不是因为它”理解”重力,而是因为训练数据中”苹果””掉落”经常一起出现
- 它没有身体,不能感知世界——哲学家 Hubert Dreyfus 在 1972 年就指出,人类智能与身体经验密不可分,一个没有身体的系统无法真正理解”冷””热””疼””饿”意味着什么
要让 AI 真正”理解”世界,学术界认为至少需要两个方向的突破:
- 世界模型(World Models):让 AI 不只匹配文字模式,而是在内部建立一个对物理世界的模拟——这是 LeCun 正在研究的方向
- 神经符号融合(Neuro-Symbolic AI):把神经网络的模式匹配能力和传统符号逻辑的推理能力结合起来——这是 Marcus 长期倡导的方向
这些方向都还在研究阶段。用我们的框架来说:底层原理还没有发生根本改变。 在改变发生之前,第 12 篇的四条原则依然成立。
那么有没有人预测这种改变什么时候到来?
有。而且分歧巨大。
根据 80,000 Hours 对专家预测的综合分析:Metaculus 预测平台上的预测者认为有 25% 的概率在 2029 年前实现 AGI(通用人工智能),50% 的概率在 2033 年前。Elon Musk 认为 2026 年就可能出现超越人类最聪明个体的 AI。DeepMind 的 Demis Hassabis 则更谨慎,认为到 2030 年底有约 50% 的概率实现 AGI。而 LeCun 认为达到人类水平的智能至少还需要几十年。
一项对超过 8500 条 AGI 预测的综合分析给出的中位数是大约 2040 年。
但这里有一个重要的警告:这些预测的”AGI”,定义各不相同。 有的人说的是”能通过所有人类考试的 AI”(这可能很快就能做到——因为考试本质上是模式匹配),有的人说的是”能像人一样理解世界的 AI”(这需要底层原理的根本突破)。
用我们的框架来看:「通过所有考试」和「真正理解」之间的鸿沟,就是第 7 篇讲的「统计匹配」和「因果理解」之间的鸿沟。 前者可能很快到来,后者的时间表真的没人知道。
第三个问题:AI 会不会有意识?
这个问题更难回答——但我可以告诉你目前学术界是怎么想的。
2025 年,剑桥大学哲学家 Tom McClelland 发表了一项研究,认为我们可能永远无法确定 AI 是否拥有意识。他的理由很简单:我们连人类意识是怎么产生的都没有完全搞清楚,怎么可能判断一个 AI 有没有意识?
哲学家 David Chalmers(提出”意识的困难问题”的那位)说,当前的大语言模型最大可能是没有意识的,但他不完全排除这种可能。他认为我们在和 LLM 对话时,面对的是一个”拥有类信念和类欲望的类主体”——“类”这个字很关键,就像一个演员在舞台上表演”愤怒”,那不是真的愤怒,而是训练出来的”看起来像愤怒”的表演。AI 的”信念”和”欲望”也是如此——统计模式匹配出来的”看起来像”信念和欲望的东西。
用我们学过的原理来想这个问题:
你在第 4 篇里知道了,神经网络的本质是”乘法和加法的层层叠加”。你在第 8 篇里看到了,ChatGPT 回答你的三秒钟里,发生的是 1750 亿个参数的数学运算。
乘法和加法能产生意识吗?
说实话,没有人知道。我们甚至不清楚人类的意识是怎么从大脑的神经元活动中”涌现”出来的。但至少有一点是明确的:你不需要因为”AI 说话听起来很像人”就恐慌。 你现在知道那些像人的回答是怎么来的——统计模式匹配,不是”思考”。
McClelland 指出了一个值得警惕的事情:如果你基于”AI 有意识”这个错误前提和 AI 建立情感连接,这可能对你自身是有害的。他说得更直接——科技公司宣传 AI 具有某种意识或情感,更像是一种营销策略,而不是科学判断。
AI 是一面镜子
写这个系列的过程中,有一个意料之外的收获。
我原本只是想搞懂 AI 是怎么工作的。但研究得越深,我越频繁地想到一个完全不同的问题:
人类智能到底是什么?
AI 能通过律师考试(第 9 篇),但分不清”谢谢你”是真心还是讽刺。AI 能画出以假乱真的图片(第 10 篇),但那也只是从噪声中还原训练数据里的统计模式——它画不出”孤独是什么感觉”。AI 能下棋赢世界冠军(第 11 篇),但不知道赢了意味着什么。AI 能写出关于爱情的诗歌,但不知道被爱是什么感受。
这些 AI 做不到的事情——常识推理、共情、价值判断、创造性思维、对意义的感知——它们有一个共同特点:都无法简单地转化为”在数据中寻找统计模式”。
它们需要的是理解,不是匹配。需要的是体验,不是计算。
Dreyfus 在 1972 年就说过:人类的世界是由有身体的人组织起来的,一个没有身体的系统无法真正进入这个世界。认知科学家近年来的研究也支持这个观点——具身认知理论(Embodied Cognition)指出,人类认知深深植根于身体感觉和运动经验中,纯粹的计算系统与此有着本质的不同。
MIT 与 IBM 的一项联合研究发现了一个很好的例子:大语言模型可以非常流畅地给你指路纽约的街道,但它实际上并不理解这座城市的空间结构——给它一个简单的绕路任务,它就会完全崩溃。它学会了”关于城市的文字模式”,但没有建立一个”城市的模型”。
这就是模式匹配和理解之间的鸿沟。
而这条鸿沟让我意识到一件事:
AI 做不到的那些事情,恰恰定义了”人之为人”。
不是 AI 让人变得不重要。恰恰相反——AI 让我们更清楚地看到了什么才是真正重要的。
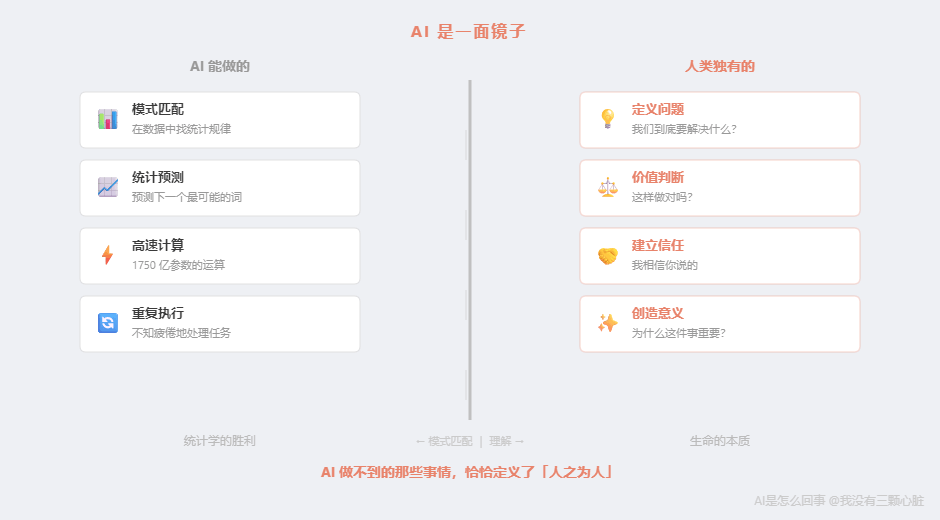
当 AI 可以帮你写初稿、翻译文档、整理数据、生成代码的时候,你的价值在哪里?就在那些 AI 做不到的地方:
- 定义问题——“我们到底要解决什么?”
- 做价值判断——“这样做对吗?”
- 建立信任——“我相信你说的”
- 创造意义——“为什么这件事重要?”
- 感受和共情——“我理解你的感受”
这些能力从来都很重要。只是在 AI 出现之前,它们被淹没在了大量重复性工作中。AI 把重复性工作接管了,于是这些真正重要的能力被凸显出来。
AI 不是来取代我们的。它是一面镜子,照出了我们真正的价值。
AI 时代,什么能力不会过时?
如果你是一个学生,或者刚进入职场,你可能在想:我应该学什么才能不被 AI 取代?
我的建议不是”学什么”,而是”怎么学”。
不要去学”怎么用某个特定工具”——工具会变。
2022 年的时候,Midjourney 是最热门的 AI 绘画工具。2024 年,很多人转向了 DALL-E 3 和 Stable Diffusion。到你读这篇文章的时候,可能又有了新的工具。如果你学的只是”Midjourney 的 50 个技巧”,那这些知识会快速贬值。
但如果你理解了 AI 的底层原理——它不会过时。
你读完这个系列获得的,不是”ChatGPT 使用技巧”。而是:
- 当你听到”某某 AI 能通过考试了”,你知道这意味着什么(模式匹配),也知道这不意味着什么(真正理解)——第 9 篇的知识
- 当你看到”AI 能画出大师级作品”,你知道它做到了什么(从噪声中还原统计模式),也知道它没做到什么(理解美)——第 10 篇的知识
- 当有人说”AI 要取代程序员了”,你能用三问判断法拆解这个说法——第 11、12 篇的知识
- 当你使用 AI 工具时,你知道为什么给更多上下文会有更好的输出——第 13 篇的知识
这是一套判断框架,不是一组使用技巧。框架不会因为工具更新而过时。
第 12 篇里我们说过:AI 在快速进步,但本质没变。只要 AI 的底层仍然是”在数据中寻找统计模式”,我们建立的整套框架就成立。等到有一天底层原理真的发生了根本变化——你也有能力识别出那个变化,因为你理解了当前原理是什么。
一个邀请
这个系列是我学习 AI 的一份”探索笔记”。
它覆盖的是此刻——2026 年初——AI 技术的快照。AI 在快速发展。你读这篇文章的时候,可能已经有了新的模型、新的能力、新的争论。
但我希望你带走的不是这份快照本身,而是拍快照的能力。
有了第一章建立的基础知识(数据都是数字、神经网络是乘法加法、训练是调参、Transformer 让 AI 读懂上下文),你已经有能力自己追踪 AI 的进展了。
当你看到一个新的 AI 产品,你可以问:
- 它的底层还是模式匹配吗?
- 它解决的问题满足”三问判断法”的三个条件吗?
- 它的”突破”是规模上的(更大的模型、更多的数据),还是原理上的(全新的架构、全新的学习方式)?
如果是规模上的突破——我们的框架依然适用,只是 AI 能做的事更多了。
如果是原理上的突破——那才是真正需要更新知识的时候。而你有能力识别这个区别。
这就是”探索笔记”的意义——不是给你鱼,是教你钓鱼。
全系列回顾
16 篇文章,一条完整的弧线:从好奇到理解,从理解到行动。
| 章节 | 篇目 | 标题 | 核心知识 | 一句话总结 |
|---|---|---|---|---|
| 第一章 | 第 1 篇 | AI 到底聪明在哪? | 图片=数字矩阵,Sobel 算子,层层检测 | AI 看到的不是图片,是数字 |
| 拆开黑箱 | 第 2 篇 | AI 怎么读懂文字? | Token,词向量,语义=距离 | AI 读到的不是文字,是高维空间的点 |
| 第 3 篇 | AI 是怎么突然变厉害的? | AlexNet,三要素(数据+算力+算法) | 2012 年不是进步,是换了赛道 | |
| 第 4 篇 | 神经网络到底是什么? | 输入 x 权重+偏置→激活→输出 | 神经网络就是乘法和加法 | |
| 第 5 篇 | AI 是怎么学会的? | 反向传播,过拟合,GPU 并行 | 训练就是用数据调参,GPU 负责算 | |
| 第 6 篇 | ChatGPT 为什么能对话? | 注意力机制,Transformer,GPT 系列 | Transformer 让 AI 能同时看全文 | |
| 第 7 篇 | AI 为什么会撒谎? | 幻觉,对抗样本,统计≠理解 | 模式匹配不等于理解 | |
| 第 8 篇 | ChatGPT 的三秒钟 | 全流程串联,核心结论 | AI 是超级模式匹配器 | |
| 第二章 | 第 9 篇 | AI 到底有多聪明? | RLHF,语言模型能力边界,判断框架 | ChatGPT 不”知道”,只”预测” |
| 能力边界 | 第 10 篇 | AI 能创造吗? | Diffusion,CLIP,AI 绘画原理 | “创造”也是模式匹配——从噪声中还原统计模式 |
| 第 11 篇 | 为什么 AI 能赢世界冠军却开不好车? | AI 能力全景图,模式匹配谱系,三问判断法 | AI 的强弱取决于三个条件 | |
| 第 12 篇 | 这个框架会过时吗? | AI 认知三角,天花板与突破方向,四条原则 | 框架不是基于 AI 能做什么,而是基于 AI 的原理 | |
| 第三章 | 第 13 篇 | 怎么让 AI 听懂你的话? | Prompt 原理,上下文=概率分布 | Prompt 不是咒语,是给 AI 更好的上下文 |
| 一起工作 | 第 14 篇 | 怎么跟 AI 协作不翻车? | 四条协作原则,验证>信任 | 把 AI 当最强助手,不要当专家 |
| 第 15 篇 | AI 写代码有多厉害? | VibeCoding,语法 vs 思考 | AI 降低的是门槛,不变的是思考 | |
| 第 16 篇 | AI 会取代我们吗? | 全系列串联,AI 与人类的边界 | AI 不懂孤独——这恰恰定义了”人” |
个人锚点
如果你真的从第 1 篇读到了这里,你可能也经历了类似的认知转变。
第 7 篇读完 AI 幻觉之后,你可能也想过一个问题:如果 AI 这么”聪明”,都只是在做统计模式匹配——那我们人类做的事情,有多少也是在”匹配”?我们多少判断是基于”以前见过类似的情况”,而不是真正的”理解”?
第 11 篇读完 AI 能力全景图之后,你看待自己工作的方式可能也开始变了。你开始有意识地区分:今天做的事情里,哪些是”模式匹配”(套模板、做重复决策、走流程),哪些是”真正需要思考的”(定义新问题、做困难的价值判断、和人建立信任)。
第 15 篇读完 VibeCoding 之后,一个结论变得越来越清晰:AI 暴露的不是人类的弱点,而是人类的核心。 当 AI 把编程的语法门槛降低之后,暴露出来的是——真正难的从来不是语法,而是想清楚你要做什么。
研究 AI 的过程,其实是一个重新认识自己的过程。
你以为你在学 AI,但你同时在学”什么是人”。
AI 能做的事情——模式匹配、统计预测、高速计算——让你看到人类也擅长这些,但不止于此。
AI 做不到的事情——理解、共情、创造意义、感受孤独——让你看到这些才是你最核心的部分。
结尾
AI 不是魔法,是统计学的胜利。
1750 亿个参数的乘法和加法,在几万亿个词的训练数据中找到统计模式,然后预测下一个最可能的词。仅此而已。
但”仅此而已”就已经够惊人了——它让机器能对话、能翻译、能画画、能写代码。这不是”人工智能”的胜利,这是统计学和工程学的胜利——是人类用自己的数学和工程能力,创造出的一个前所未有的工具。
而理解这一点本身,就是一种力量——它让你在一个充满 AI 炒作和恐惧的世界里,拥有了自己的判断力。
AI 能写出关于孤独的优美文字。但它从未在凌晨三点醒来,盯着天花板,感到一种说不清的空洞。
1750 亿个参数里没有这种感觉。几万亿个词的训练数据里也没有。
它只在你的生命里。
感谢你陪我走过这 16 篇。
这不是一个结束——带着你对 AI 的理解,这其实是一个开始。
参考资料
- Searle, J. (1980). Minds, Brains, and Programs. Behavioral and Brain Sciences. Wikipedia: https://en.wikipedia.org/wiki/Chinese_room — John Searle 1980 年提出的”中文房间”思想实验,论证计算机不能真正理解语言
- Dreyfus, H. (1972). What Computers Can’t Do. Wikipedia: https://en.wikipedia.org/wiki/Hubert_Dreyfus%27s_views_on_artificial_intelligence — Dreyfus 关于具身认知与 AI 局限性的哲学批评(1972 年《What Computers Can’t Do》)
- Embodied Cognition and AI. Philosophical Transactions of the Royal Society B. https://royalsocietypublishing.org/doi/10.1098/rstb.2019.0694 — 皇家学会关于具身认知与 AI 关系的学术论文
- Manvi, R., et al. (2023). Large Language Models are Geographically Biased. arXiv. https://arxiv.org/abs/2310.12931 — MIT 与 IBM 联合研究:LLM 能指路但不理解城市空间结构
- 80,000 Hours. (2025). Why AI presents some of the world’s most pressing problems. https://80000hours.org/problem-profiles/artificial-intelligence/ — AGI 时间线的专家预测综合分析:Metaculus 预测 25% 概率 2029 年前,50% 概率 2033 年前
- EA Forum. (2024). AGI by 2032 is extremely unlikely. https://forum.effectivealtruism.org/posts/sQSCqpm9Ymwiu8rdb/agi-by-2032-is-extremely-unlikely — 对 8590 条 AGI 预测的综合分析,中位数约 2040 年
- The Decoder. (2024). The case against predicting tokens to build AGI. https://the-decoder.com/the-case-against-predicting-tokens-to-build-agi/ — Yann LeCun 认为大语言模型是通向 AGI 的”死胡同”
- Marcus, G. (2025). The Great AI Retrenchment has begun. Substack. https://garymarcus.substack.com/p/the-great-ai-retrenchment-has-begun — Gary Marcus 关于统计模式匹配无法产生真正理解的论述
- McClelland, T. (2025). We may never be able to tell if AI becomes conscious, argues philosopher. University of Cambridge. https://www.cam.ac.uk/research/news/we-may-never-be-able-to-tell-if-ai-becomes-conscious-argues-philosopher — Tom McClelland 论证我们可能永远无法判断 AI 是否有意识
- Chalmers, D. (2024). Interview on AI consciousness. The New York Times. https://www.nytimes.com/2024/03/29/science/ai-consciousness-david-chalmers.html — David Chalmers 认为当前 LLM”最大可能没有意识”
- World Economic Forum. (2025). The Future of Jobs Report 2025. https://www.weforum.org/publications/the-future-of-jobs-report-2025/ — 预测 2025-2030 年全球净增 7800 万个工作岗位,文员岗位下降最多
- McKinsey Global Institute. (2023). Generative AI and the future of work in America. https://www.mckinsey.com/mgi/our-research/generative-ai-and-the-future-of-work-in-america — 超过 70% 的雇主看重的技能既用于可自动化工作也用于不可自动化工作
- The Federal. (2025). AI titans Demis Hassabis, Yann LeCun clash over meaning of ‘general intelligence’. https://thefederal.com/category/business/ai-chiefs-demis-hassabis-yann-lecun-lash-over-general-intelligence-meaning-222118 — Hassabis 预测 2030 年底前 50% 概率实现 AGI,LeCun 认为至少需要几十年
- Lake, B.M. & Murphy, G.L. (2023). Word meaning in minds and machines. Psychological Review. https://psycnet.apa.org/record/2023-32499-001 — AI 模式匹配与人类理解的认知科学对比
- Mitchell, M. & Krakauer, D.C. (2023). The debate over understanding in AI’s large language models. PNAS. https://www.pnas.org/doi/10.1073/pnas.2215907120 — AI 基于概率的后向推理 vs 人类基于理论的前向推理